はじめに
アプリケーションのトラフィックが増大するにつれ、PostgreSQLのようなリレーショナルデータベースが最大のボトルネックとなるケースが多々あります。Supabaseのようなフルマネージドプラットフォームは運用オーバーヘッドを大幅に削減してくれますが、大量の同時読み書き(Read/Write)スパイク発生時に10ミリ秒未満のクエリ実行速度を維持するには、意図的なアーキテクチャ設計が不可欠です。
本プレイブックでは、エンタープライズグレードの処理能力を実現し、ロック競合、CPU使用率の高騰、コネクション枯渇を撲滅するために、Isotope Blueで実践しているSupabaseおよびPostgreSQLバックエンドの拡張戦略を解説します。
1. コネクション管理とプーリング戦略
PostgreSQLのデフォルトのプロセスモデルでは、アクティブな接続ごとに個別のバックエンドプロセスが割り当てられるため、膨大なメモリオーバーヘッドが発生します。急激なトラフィック増加時には、生の接続要求がシステムリソースを急速に食いつぶしてしまいます。
アーキテクチャ上の解決策:
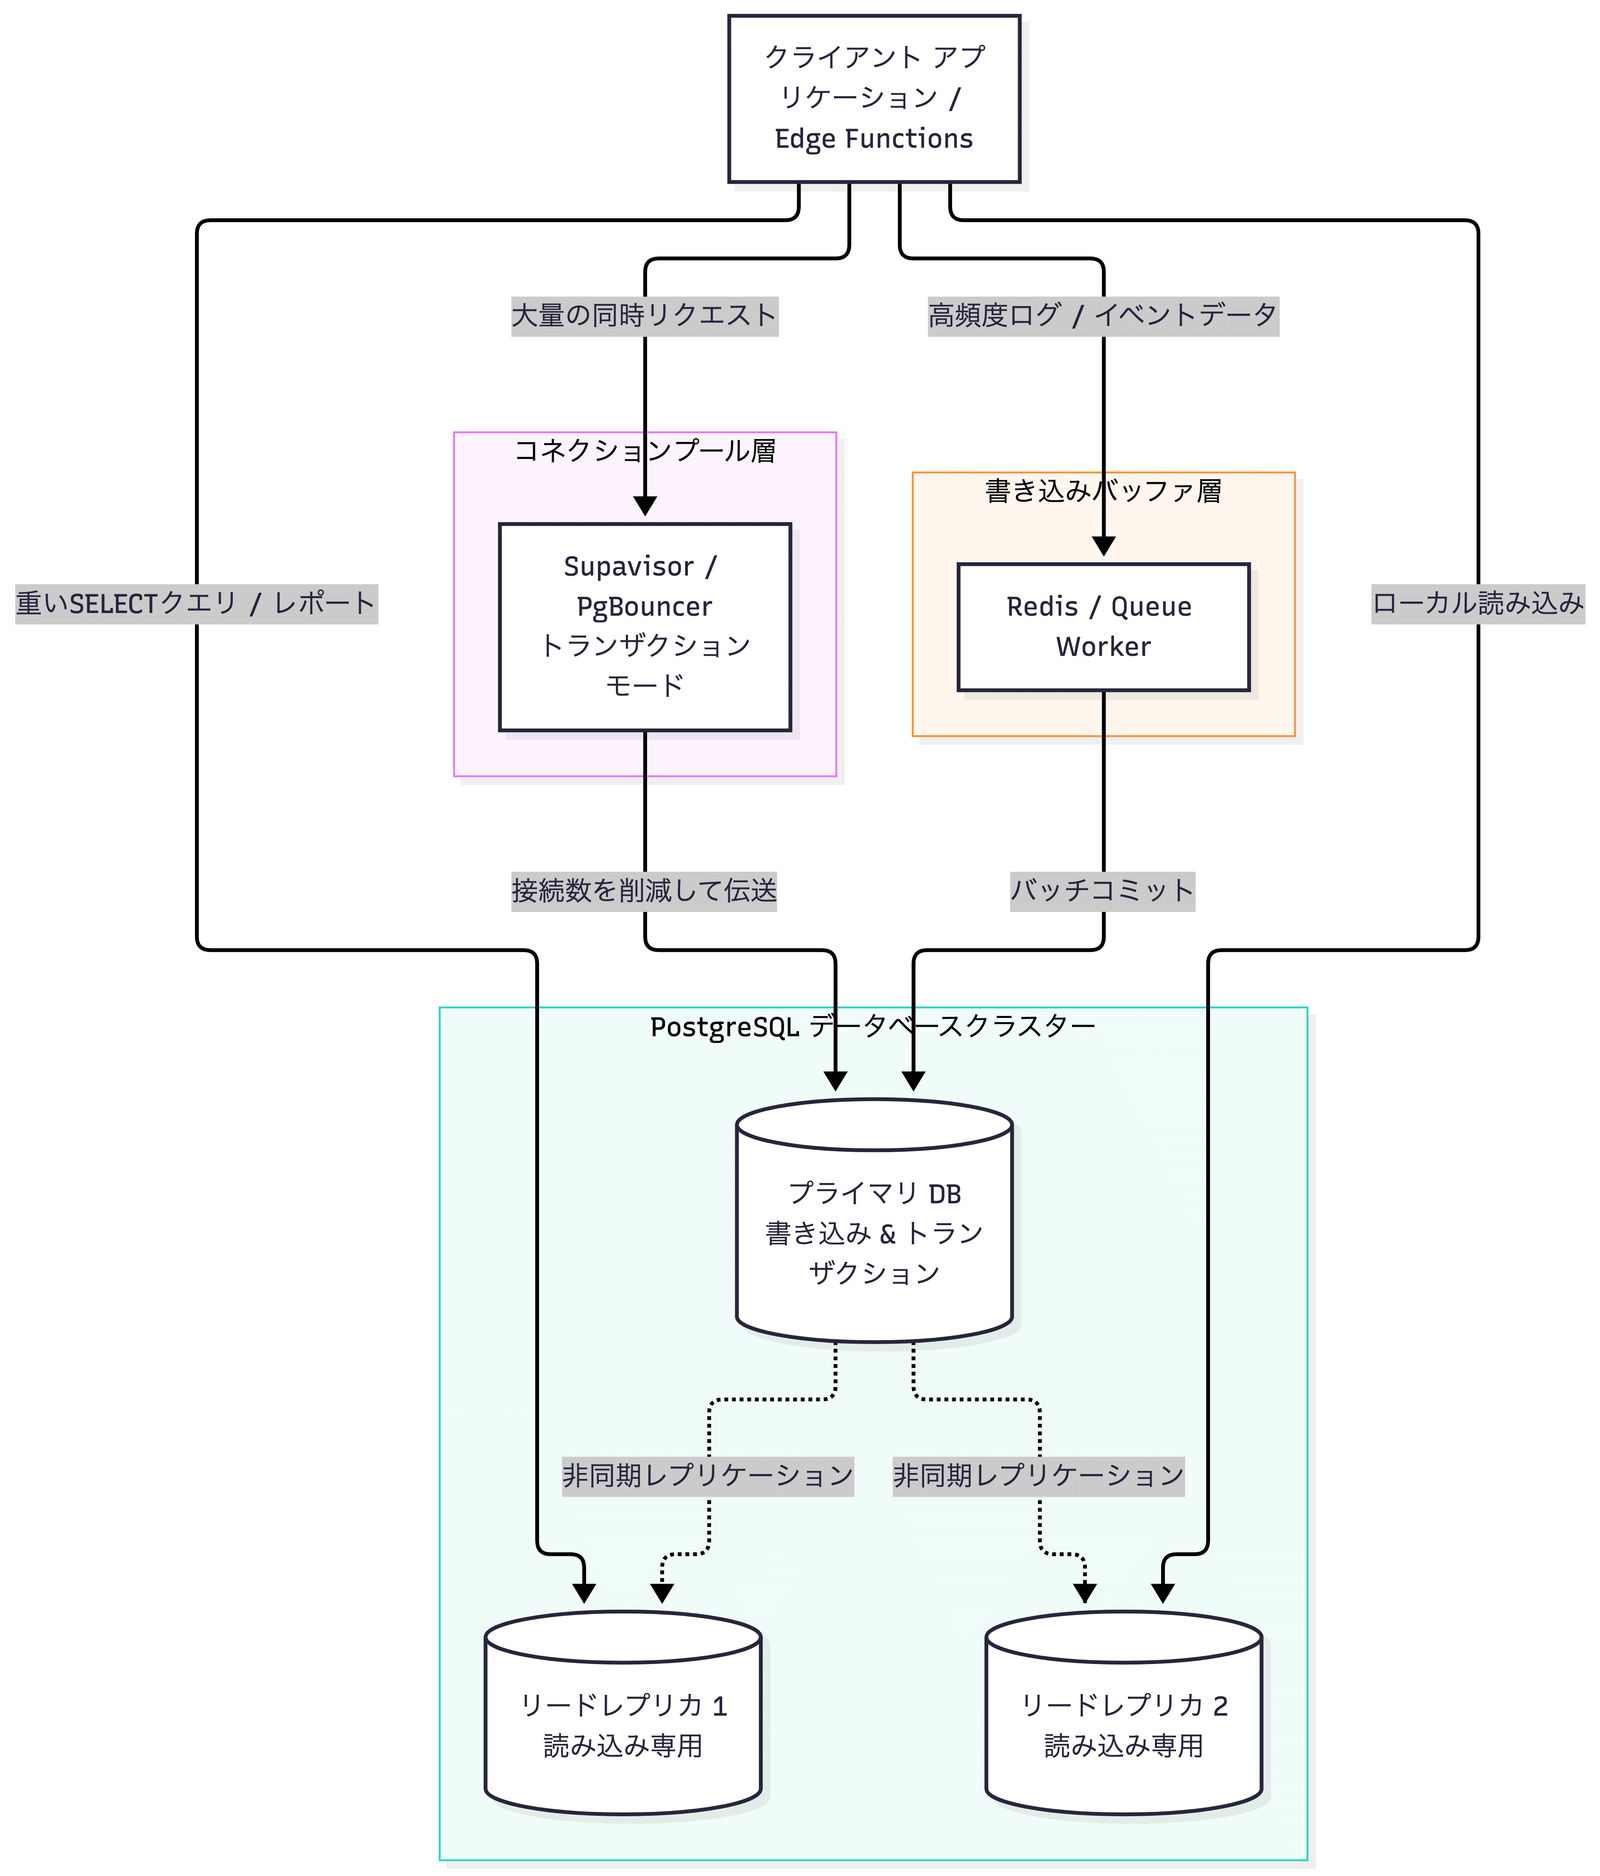
- Supavisor / PgBouncerによるトランザクションレベルのプーリング: プーラーを「セッションモード」ではなく「トランザクションモード」で設定します。これにより、数千ものクライアントアプリが極めて少ないアクティブサーバー接続を効率的に共有できるようになり、メモリ使用量を最大80%削減できます。
- 長時間タスク用の直接接続の分離: 生のPostgreSQL直接接続(Direct Connection)は管理タスク、スキーママイグレーション、またはリアルタイムリスナー専用とし、すべてのアプリケーションHTTPリクエストやAPI Edge Functionsはトランザクションプール経由で実行します。
2. クエリ最適化とインデックス運用の徹底
実行速度の遅いクエリはデータベース接続を占有し、ロックを保持してCPUを圧迫します。高スループットなパフォーマンスを実現するには、フルテーブルスキャン(シーケンシャルスキャン)を完全に撲滅する必要があります。
実践的タクティクス:
- 部分インデックスと複合インデックスの活用: 単一カラムごとに闇雲にインデックスを作成するのは避けてください。複数カラムの
WHEREやORDER BY句を狙い撃ちした複合インデックスを作成し、さらに部分インデックス(WHERE active = trueなど)を活用してインデックスサイズを極小化し、RAM上に常駐させます。 - カバリングインデックス(
INCLUDE句): 頻繁に取得するデータフィールドをインデックス自体に含めることで、インデックスオンリースキャン(Index Only Scan)を有効化します。これにより、PostgreSQLはディスク上のテーブルページにアクセスすることなく、インデックスのみからクエリ結果を高速返却できます。 - EXPLAIN ANALYZEによる常時モニタリング: 実行時間の長いクエリを定期的に監査し、不足しているインデックス、高いバッファヒット率、予期せぬシーケンシャルスキャンを早期に特定します。
3. 書き込み競合とロックオーバーヘッドの軽減
テレメトリログ、クリックトラッキング、リアルタイムのステータス更新など、大量の書き込みが発生する処理は行ロック(Row Lock)を引き起こしやすく、データベース全体の読み取りパフォーマンスを低下させます。
アーキテクチャパターン:
- Redis / キューワーカーによる書き込みバッファリング: 微小なイベントを直接PostgreSQLに都度書き込むのではなく、高頻度の書き込みを一度インメモリデータストア(Redis)やキューシステム(n8n / Kafka)にバッファリングし、最適化されたバッチ処理としてPostgreSQLへ一括コミットします。
- 一時データ用 UNLOGGED テーブルの利用: サーバークラッシュ時の即時永続性が必須ではない一時的なセッション状態やステージングデータには、PostgreSQLの
UNLOGGEDテーブルを使用し、WAL(Write-Ahead Logging)の書き込みオーバーヘッドを回避します。
4. 行レベルセキュリティ(RLS)のパフォーマンスチューニング
Supabaseは認可モデルに行レベルセキュリティ(RLS)を全面的に採用しています。しかし、非効率に設計されたRLSポリシーは、取得する1行ごとにPostgreSQLに複雑な式やネストされたクエリの再評価を強いることになり、著しい性能低下を招きます。
最適化ルール:
- RLSポリシー参照用外部キーのインデックス化: RLSポリシー内で参照されるすべてのカラム(
organization_idやuser_idなど)には、必ず明示的にインデックスを作成してください。 - ポリシー内での相関サブクエリの撲滅: ヘルパー関数を
STABLEまたはIMMUTABLEとして定義するか、JWTクレーム(auth.jwt() -> 'app_metadata' ->> 'org_id'など)を直接参照することで、ポリシー評価時の無駄なサブクエリ実行を排除します。
5. リードレプリカとコネクションルーティング
グローバルマーケットプレイスや分析ダッシュボードなど、読み取り比率が極めて高いプラットフォームでは、SELECTクエリをプライマリ(書き込み)ノードから完全に分離させます。
デプロイメント構成:
非同期リードレプリカ: ターゲットとなる地域(リージョン)にリードレプリカを配置し、最小限のレイテンシでローカルからの読み取りリクエストを処理します。
Read / Write の分離: 書き込み処理(INSERT, UPDATE, DELETE)はすべてプライマリの接続プールにルーティングし、複雑な集計レポートクエリや読み取りリクエストはレプリカのエンドポイントへと振り分けます。
システム基盤の統合・最適化を実現
ベンダー管理の無駄を排除し、自動拡張する高信頼性システムを構築
Solutions: